⌕
Векторный поиск
Семантический поиск по документам, заметкам и коду — за миллисекунды, а не по ключевым словам.
// система второго мозга
Складывайте заметки, документы и код в один второй мозг. Векторный поиск и ИИ-агенты превращают разрозненные записи в рабочую память — по всем вашим данным сразу.
// возможности
Семантический поиск, изолированные контексты и доступ по MCP — с видимыми статусами обработки.
Семантический поиск по документам, заметкам и коду — за миллисекунды, а не по ключевым словам.
Отдельные контексты для личного, работы и проектов. Ничего не перемешивается между собой.
Подключите агента с поддержкой MCP — DeepSeek Harness, Cursor или Claude Code — и он будет искать по вашей базе и цитировать её.
Очередь, обработка, готово: прозрачные статусы, а сбойный документ можно вернуть в очередь.
// как это работает
Никаких ручных тегов и папок: нарезка, эмбеддинги и поиск берут работу на себя.
Напишите заметку в панели или поручите это агенту через remember_information. Код оформляется ограждениями и не разрывается.
Документ разбивается на чанки и превращается в векторы — статус видно на экране.
Задайте вопрос обычным языком. Поиск найдёт релевантные фрагменты, а не совпадения слов.
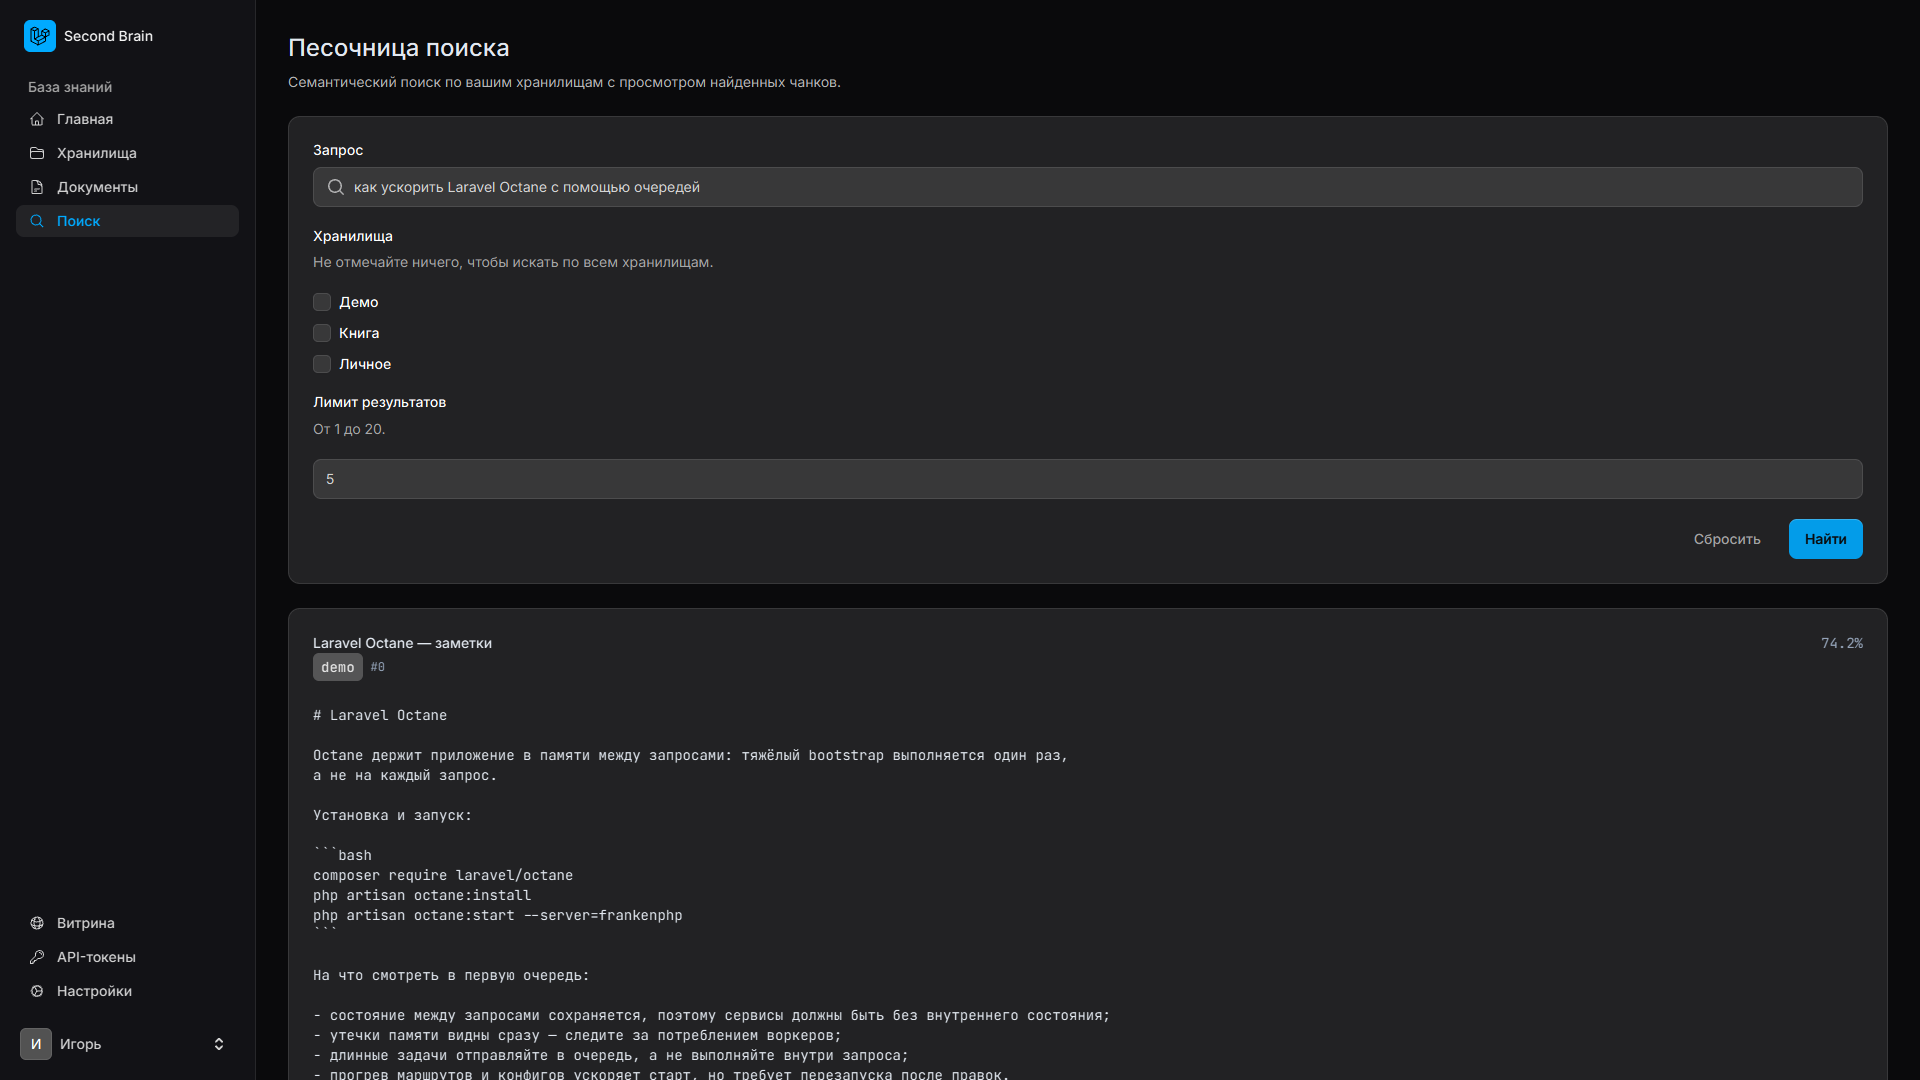
Каждый результат приходит с названием документа, номером чанка и оценкой близости — всё проверяемо, без выдуманного ответа.
// api-first
Один MCP-эндпоинт — и ваша база подключается к любому совместимому агенту: поиск, чтение чанков и цитирование источников из коробки.
Получить API-токенПример ответа search_knowledge: инструмент возвращает название документа, чанк и оценку близости.
// интерфейс
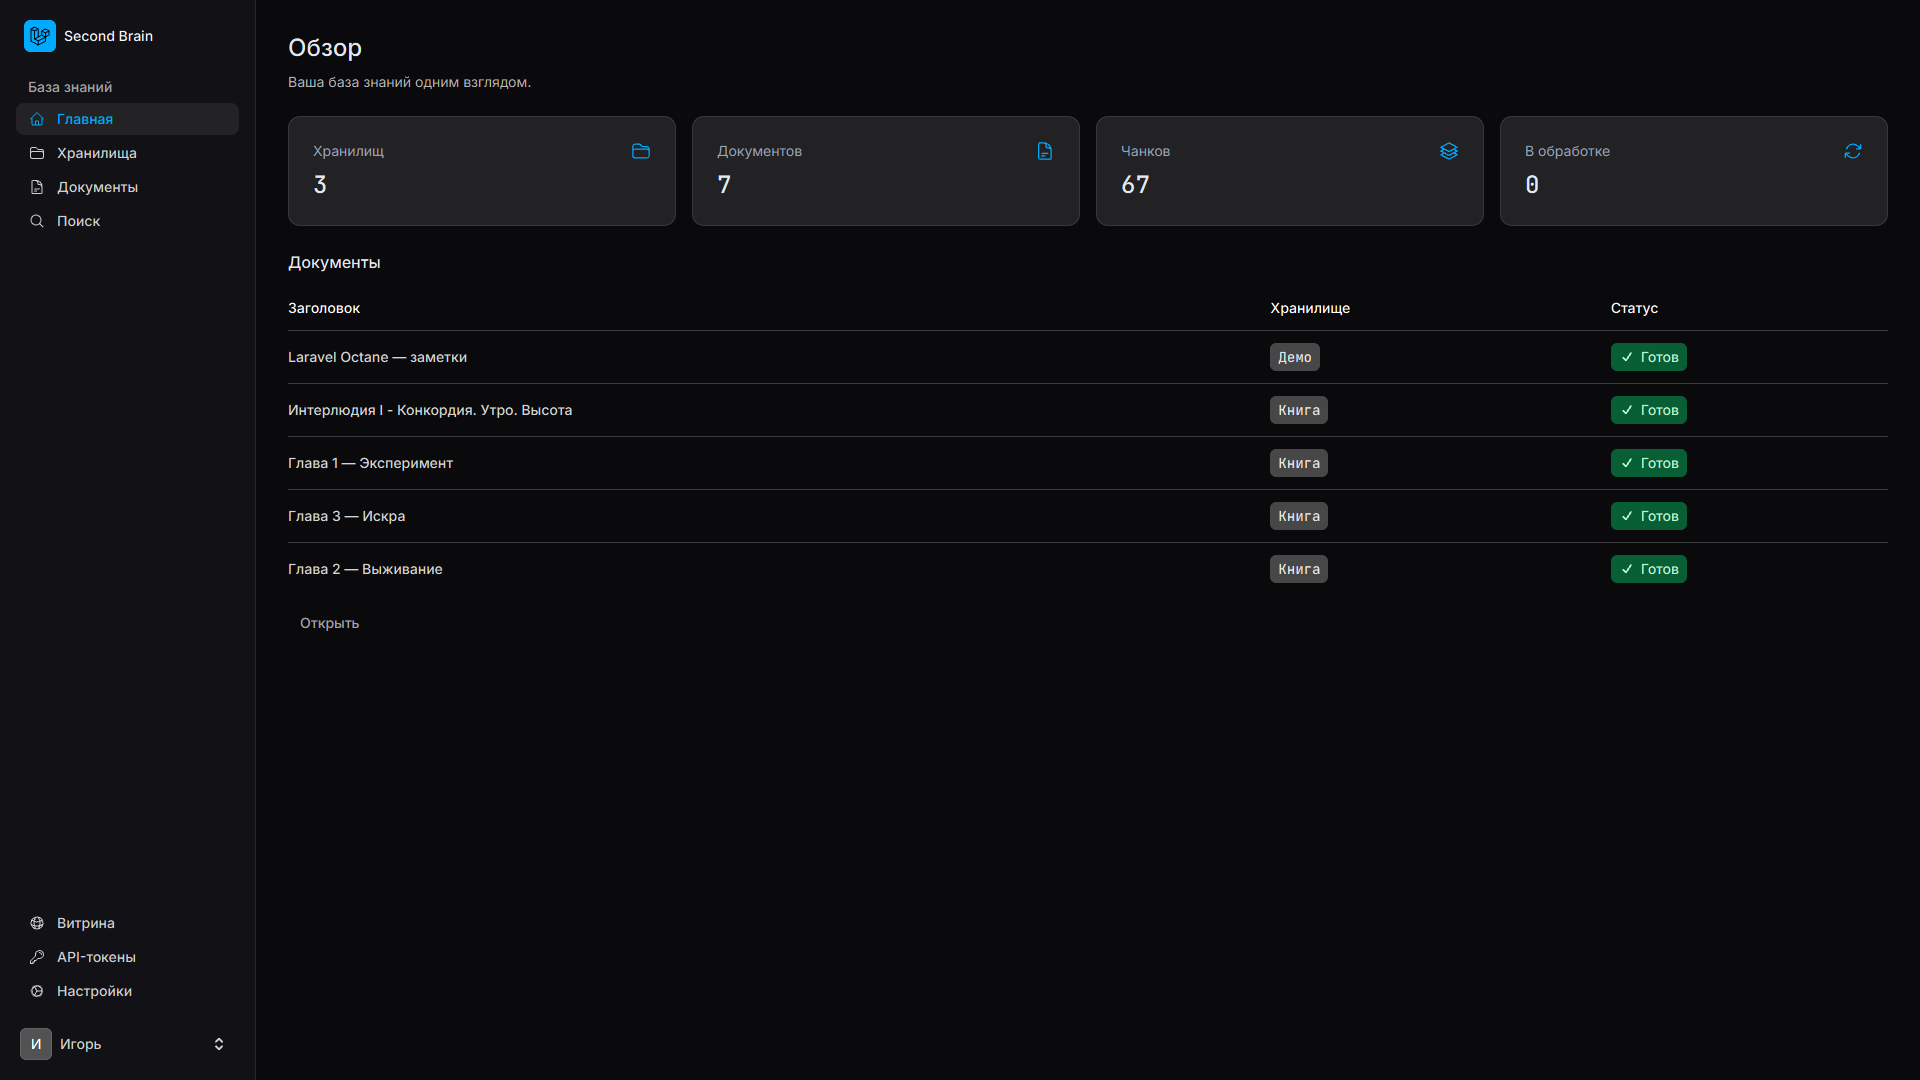
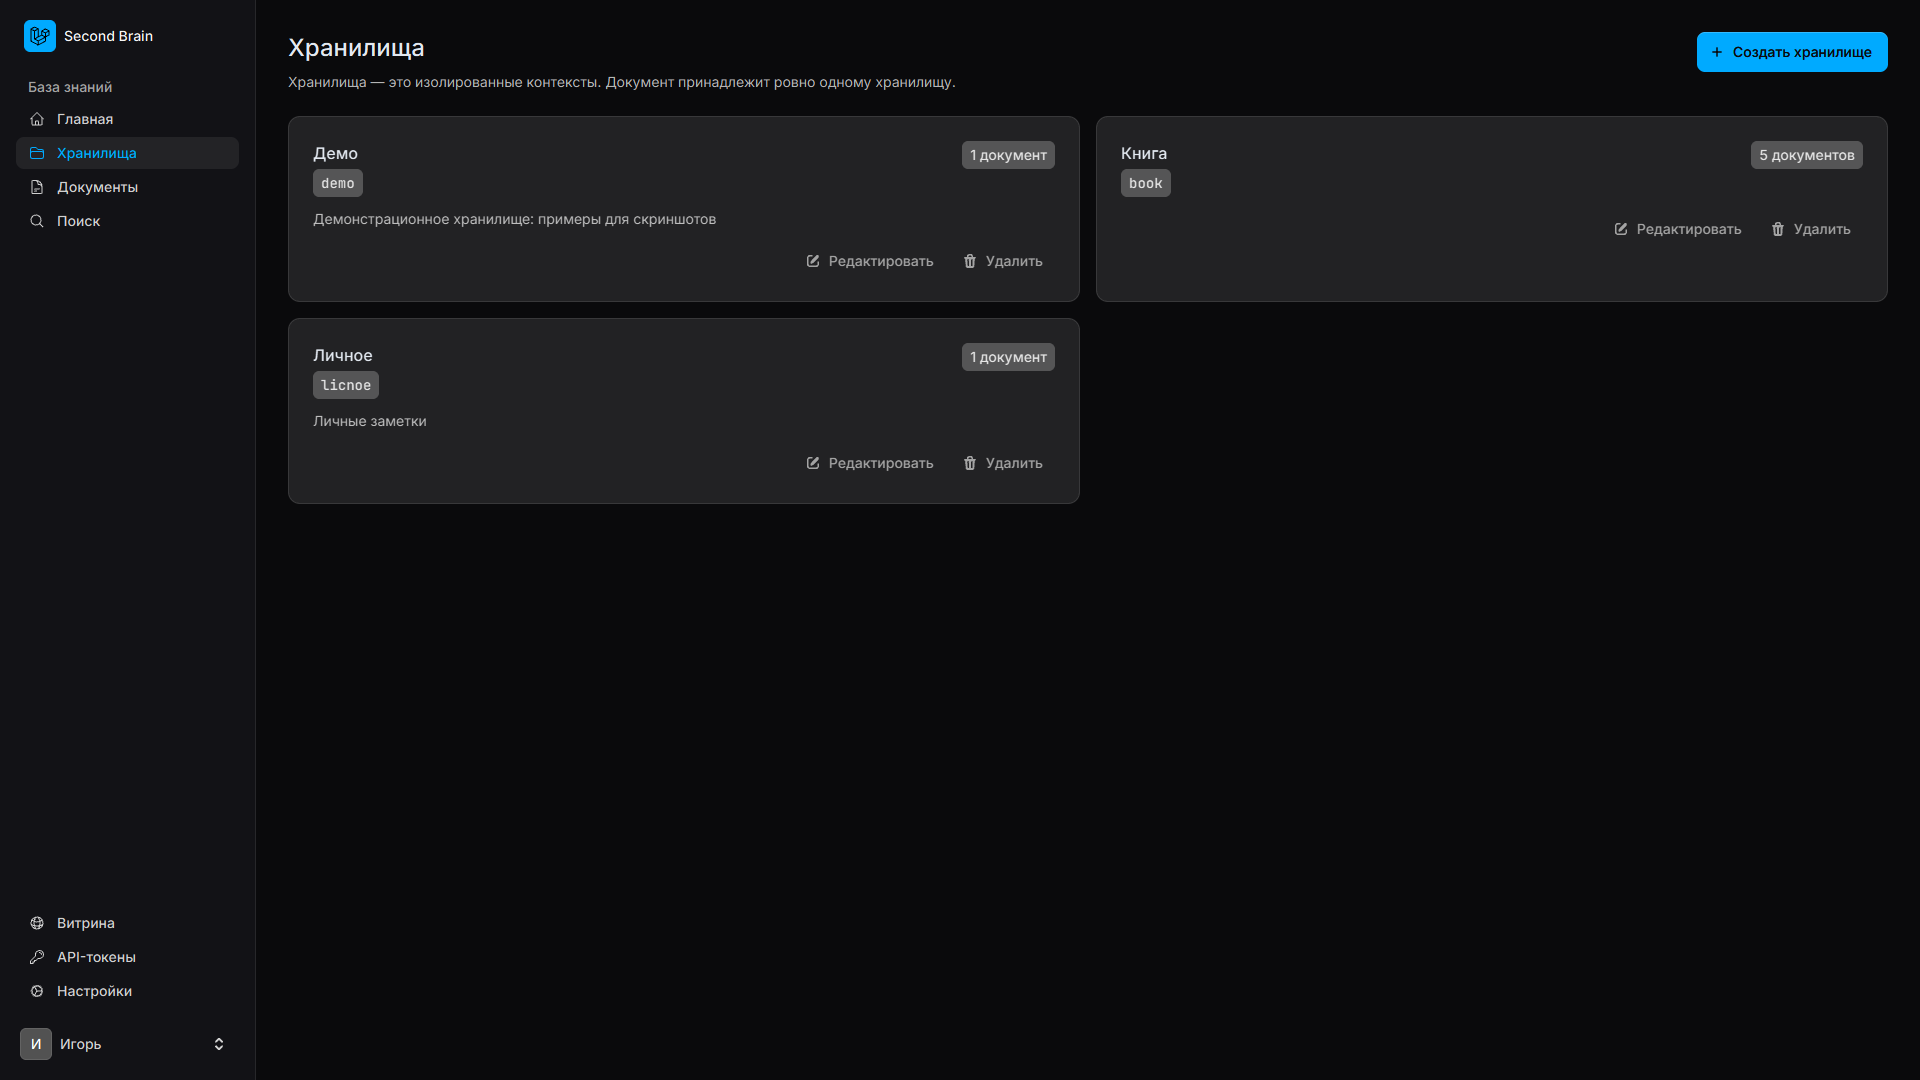
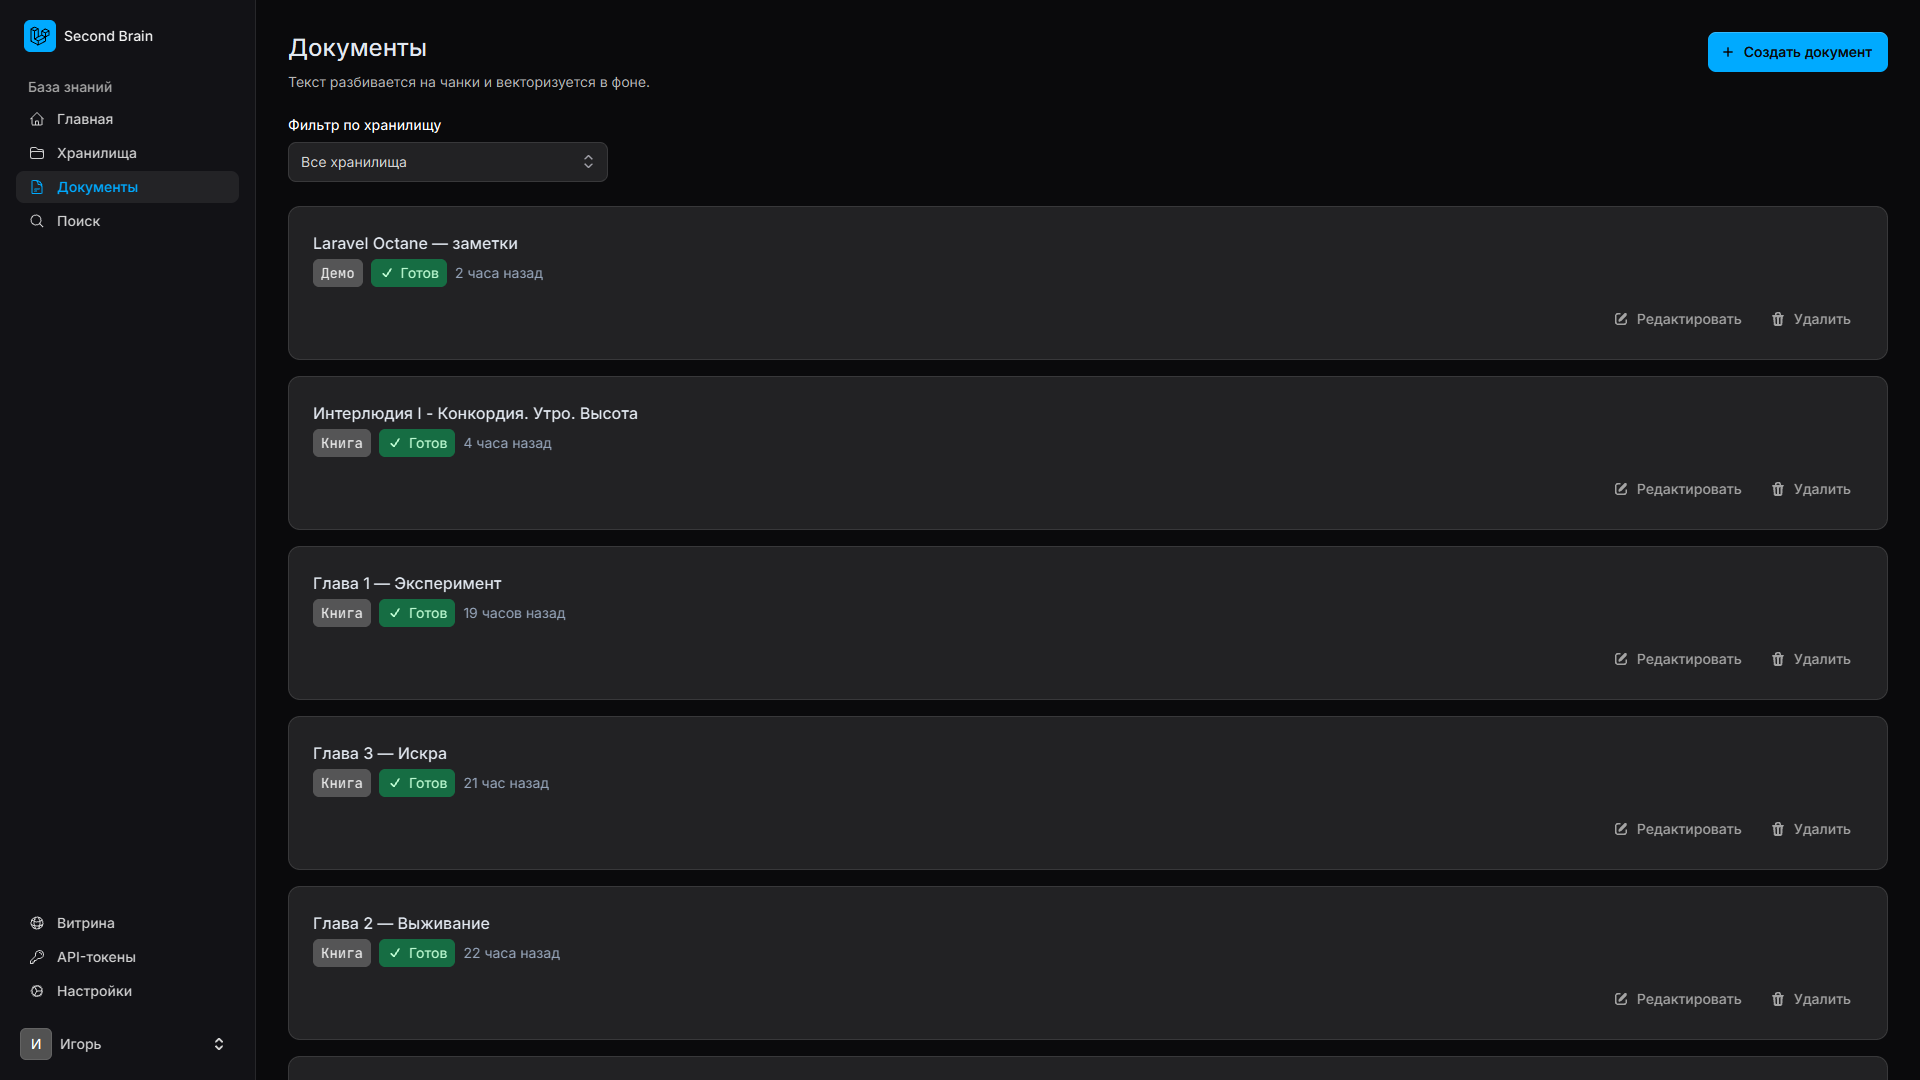
Реальные скриншоты панели: дашборд, хранилища, документы и поиск.
// старт
Разворачивается локально за пару минут. Один MCP-эндпоинт для ваших агентов.